
痛點:通用模型天生不準
我們自己就驗證過:市售翻譯機對著卡尼,零反應。所有「貓語翻譯器」都建立在同一個假設上:貓叫有一套通用語法。事實是成年貓之間的溝通幾乎不靠喵叫——喵叫主要是對人類發展出來的,每隻貓對不同的人都有不同的叫法。
假設本身錯了記下叫聲、觀察回應,
慢慢認識你家這隻貓。
Android 版已開放下載;iOS 版即將推出。
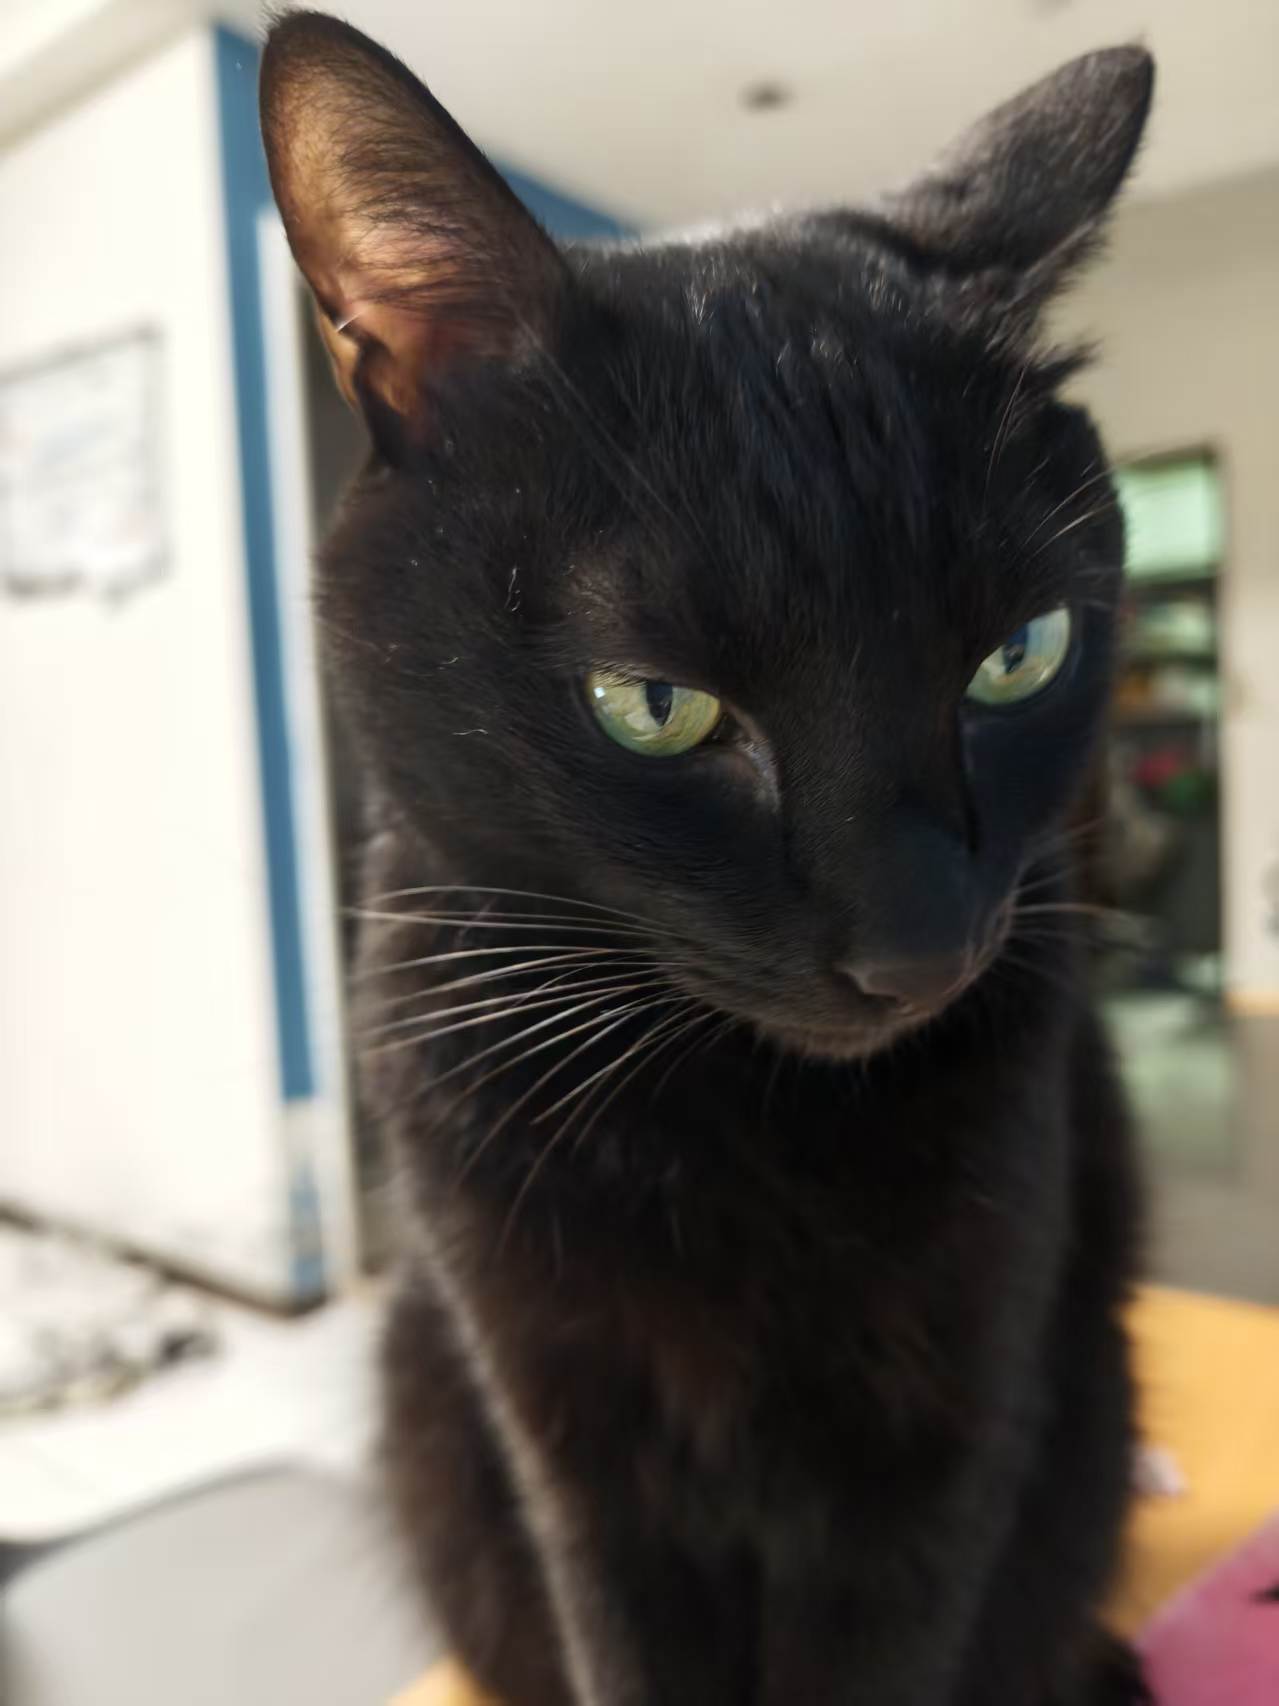
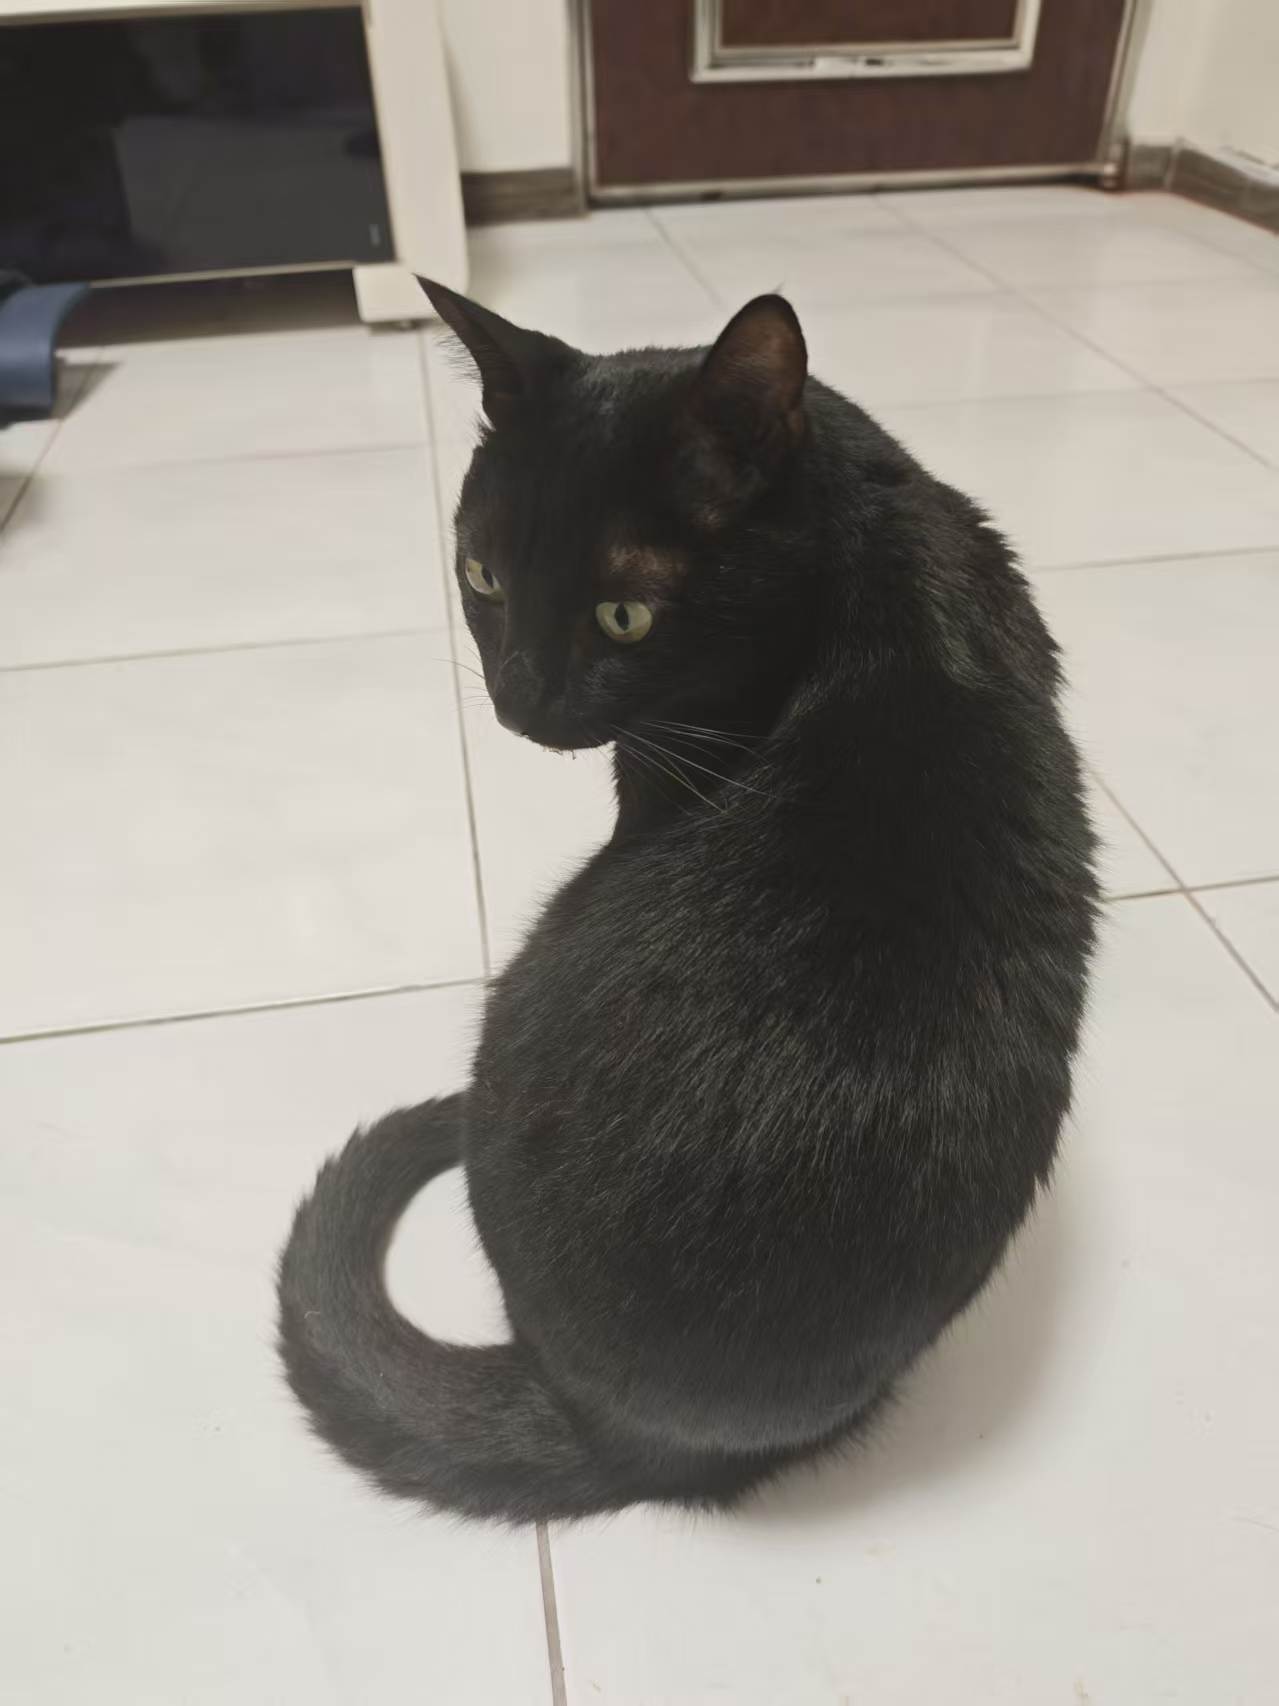
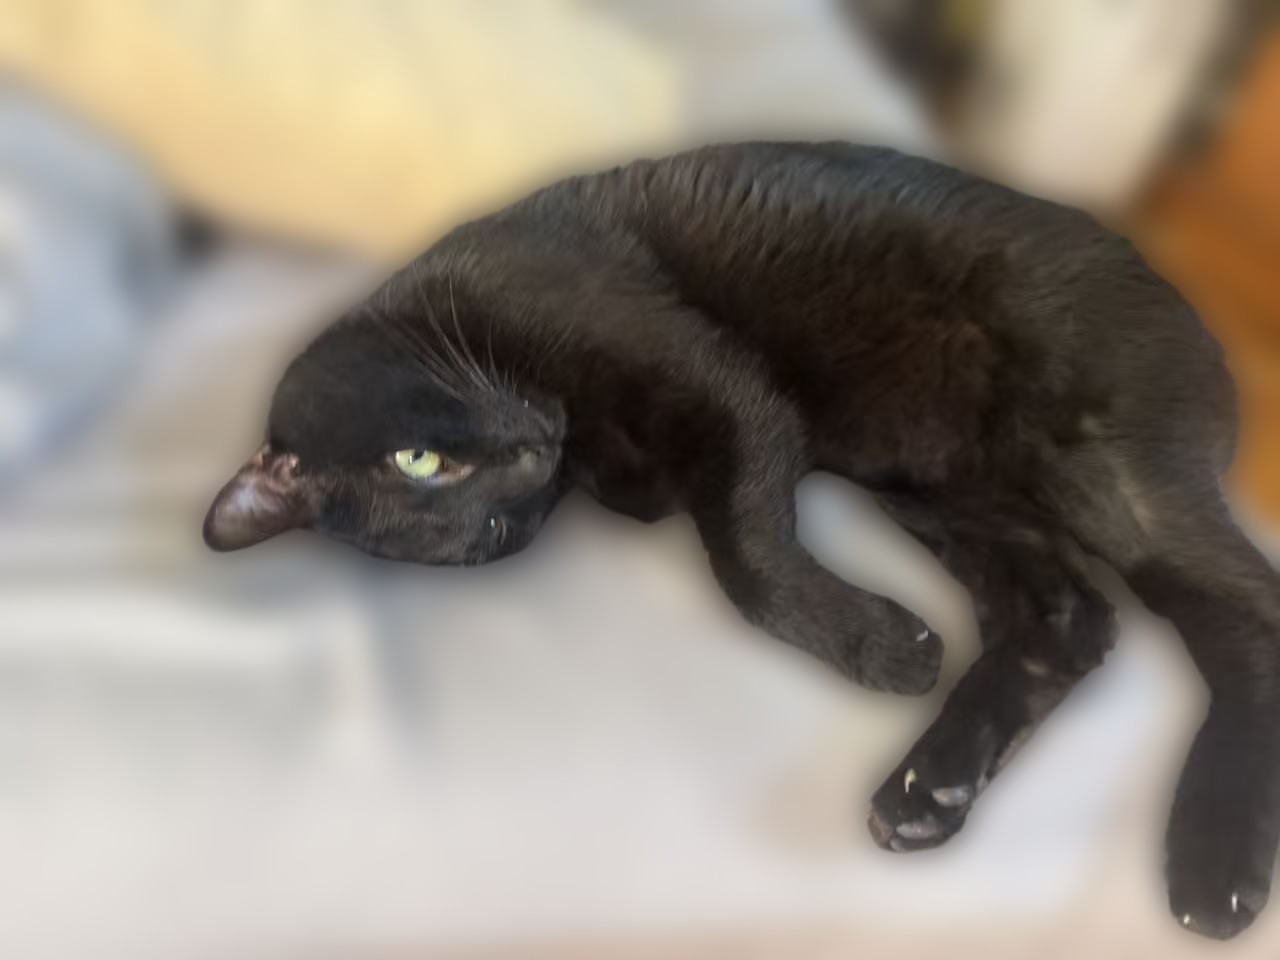
這不是行銷話術——是一隻黑貓教我們的事,加上一個技術判斷。
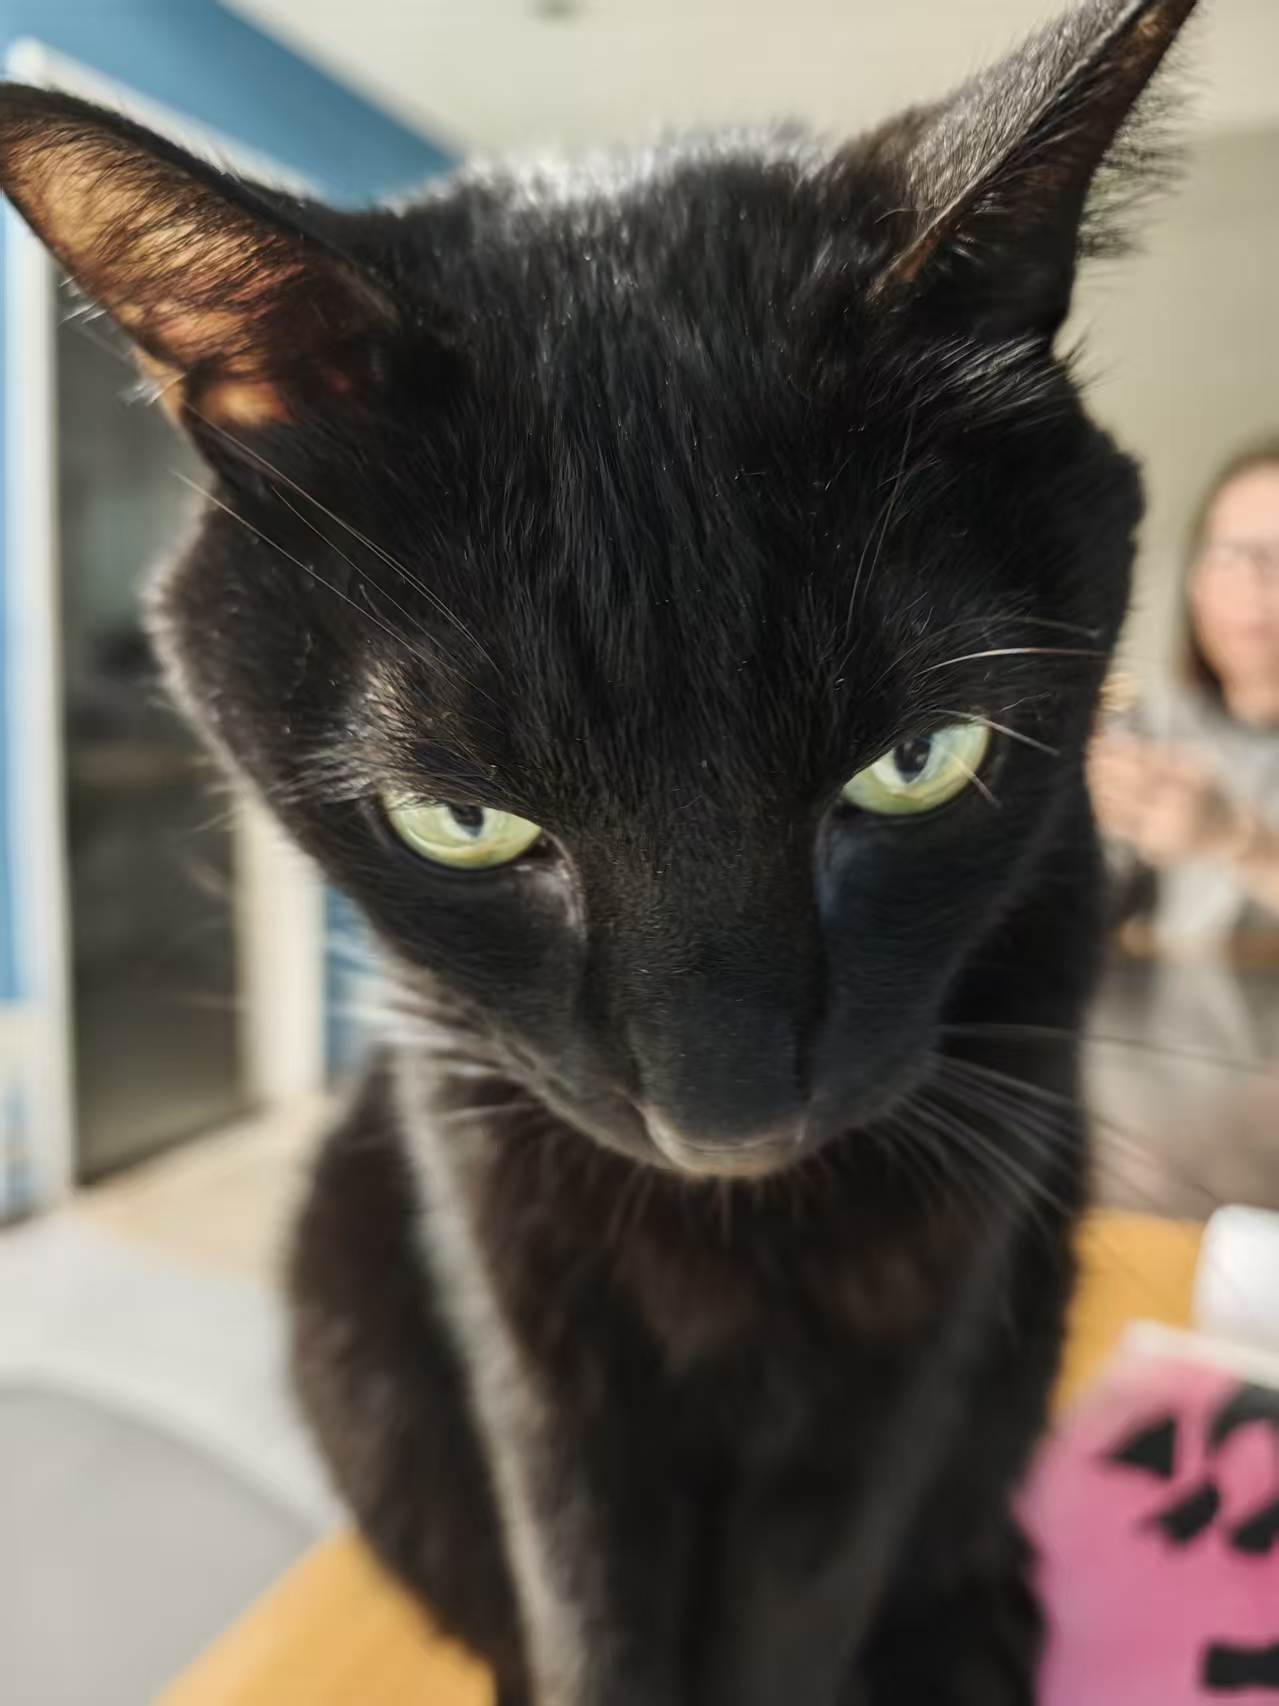
一隻酷酷的黑貓。為了跟他溝通,我們先去買了市面上的貓語翻譯機,對著他放了好幾輪——結果完全得不到他的反應。他看了機器一眼,繼續趴著。
後來我們想到一件事:家人之間常常有默契的語言或動作——不是制式的,而是你知我知的共情溝通。貓也是家人。於是我們把這份默契寫成了演算法——共情溝通演算法:不猜「全世界的貓」,只學「我們家的卡尼」。
卡尼現在是正式的品牌 IP——官網貼圖 Vol.2(照片級)與 App 手帳頁都已換上他的形象,接下來是周邊。畢竟這個產品,本來就是為他發明的。
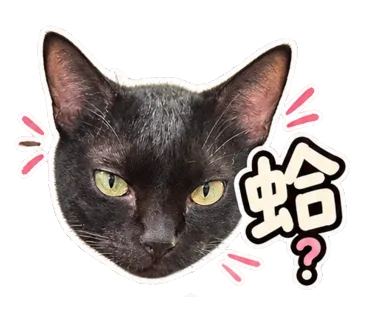
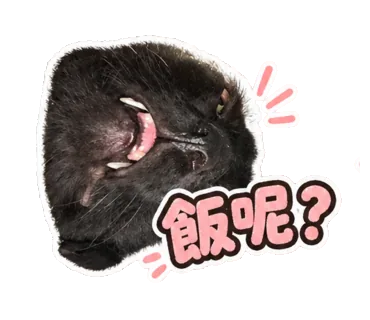
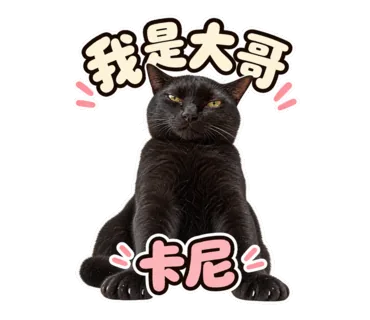
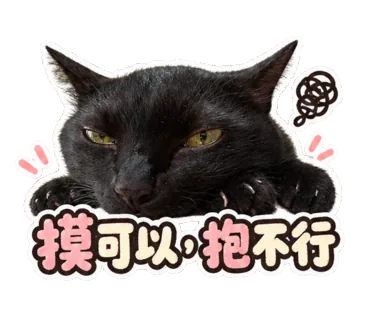
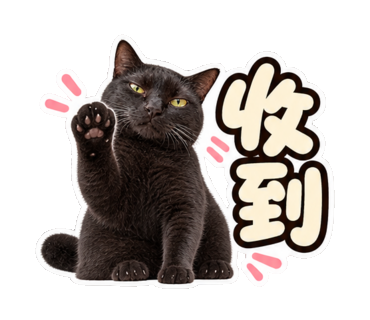
LINE 貼圖包正式設計稿(24 枚全組已完成,本頁先上四枚)。正好對應 App 的四個情境標籤:聽不懂=拒判 · 飯呢=飢餓 · 大哥卡尼=打招呼 · 摸可以抱不行=不滿。
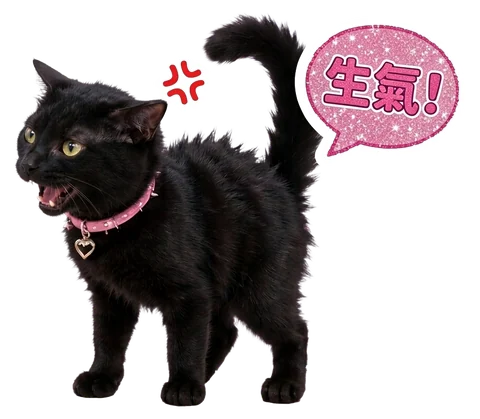
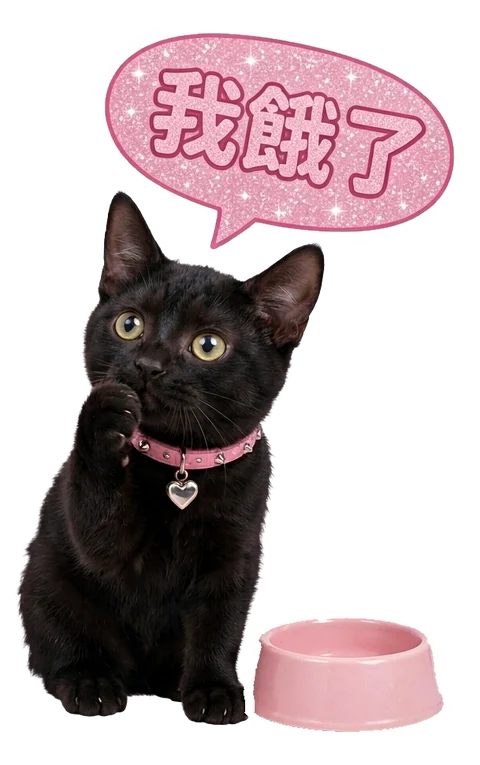
這四枚以卡尼本貓為原型(黑貓 × 粉紅拍立得項圈):真透明背景、白色模切描邊,縮到 100px 仍認得出來。 聊天直接用,App 手帳頁也已換上同一套形象。LINE 貼圖包 24 枚已定稿(見上排官方設計稿)。
「貓叫是個體方言。你家貓在『想吃飯』時的叫聲,穩定、可重複,而且獨一無二——
— 專案設計筆記
通用模型猜的是『所有貓的平均』,那個答案對你家這隻貓必然是錯的。」
業界談寵物 AI,通常分成四塊:照護、日常、收容、相遇。四塊其實都在回答同一個問題——怎麼照顧牠。
我家喵語補的是第五個維度:怎麼聽懂牠。
它落在「日常」,精神上屬於「相遇」——聽懂帶來連結,連結才守得住終養不棄養。
我們自己就驗證過:市售翻譯機對著卡尼,零反應。所有「貓語翻譯器」都建立在同一個假設上:貓叫有一套通用語法。事實是成年貓之間的溝通幾乎不靠喵叫——喵叫主要是對人類發展出來的,每隻貓對不同的人都有不同的叫法。
假設本身錯了既然是「個體方言」,就不需要海量數據——只需要你自己的幾條錄音。我們把特徵維度壓到 34 維、類中心用滑動平均維護,每類 3 條就能冷啟動。
3 條樣本即可開始這套程序最有價值的產出不是「判得準」,而是幫你找到並記錄真實存在的互動:你學著叫一個聲音,牠回應了——那一刻就成了你們之間專屬的「互動聲音」。
互動日記34 維特徵提取、分類、拒判全部在手機本地跑。錄音檔與特徵值從架構上就沒有離開裝置的路徑——不是靠政策承諾,是靠程式結構。
每類 3~5 個樣本訓不動深度模型。改用 標準化歐氏最近鄰:類均值 + 逐維方差自動加權,判定過程可解釋、可回放、不必聯網推理。
遇到沒聽過的叫聲(新的病痛呻吟、發情聲、外來貓叫),系統會拒絕判定並請你教它——而不是硬猜一個答案,還給你 100% 的信心。
現有貓叫識別技術幾乎都在同一條路上:聯網 + 深度神經網路 + 雲端推理。 我們整條技術路線反過來——離線 + 不依賴預訓練模型 + 可拒判。 這不是折衷,是針對五個既有缺陷逐一設計的結果。
34 維聲學特徵 · 雙門檻拒判
全程在手機上完成
預加重 0.97 → RMS 能量歸一化 → 25 ms 漢明窗分幀(幀移 10 ms)→ 512 點頻譜 → Mel 濾波器組(24 個,200–6000 Hz)→ 對數 → DCT-II 取 12 維 → CMVN 倒譜均值歸一化 → 自相關法基頻 → 音節數。
關鍵設計:用 RMS 能量歸一化,不用峰值歸一化。峰值會被突發噪聲(關門聲、噴嚏)偷走動態範圍——實測抗噪餘弦相似度從 0.43 提升到 0.98。
市面上幾乎沒有產品把「拒絕判定」當成第一原則。這是本方案最硬的一點,也是實測抓出來的:只用相對判據(margin)時,一段完全陌生的叫聲會被判成 100% 置信度。
d₁(候選類)、次小者 d₂
novelty = d₁ / 類內半徑 > 2.5 → 這是完全陌生的聲音
confidence = (d₂ − d₁) / d₂ < 0.55 → 聽過,但拿不準
為什麼兩個都要:margin 是相對判據(候選類比次優類好多少),novelty 是絕對判據(這個樣本離該類自己的散布有多遠)。前者回答「已知類之間分不分得開」,後者回答「它到底是不是已知類」。任一不通過即拒判。
以下數字來自 Python 參考實作與 Android Kotlin 實作的完整測試,腳本隨原始碼附上。
| 指標 | 實測 | 對照與說明 |
|---|---|---|
| 抗噪魯棒性 | 0.98 | 加噪前後特徵餘弦相似度;峰值歸一化對照組僅 0.43 |
| 小樣本準確率 | 14 / 15 | 每類 4 條樣本;Python 與 Kotlin 兩端結果一致 |
| 跨端數值一致性 | 4.4e-7 | 3 組用例 × 34 維最大相對偏差(容差 1e-3) |
| 陌生聲音拒判 | 17.45 | novelty 遠超閾值 2.5;僅用 margin 時該聲音被判 100% 置信度 |
| 自我學習 | 0.959 → 0.964 | 隨逐次確認持續提升,無需額外標註工作 |
| 嗓音漂移跟隨 | 0.507 | 模擬叫聲整體變低後類中心成功移動(遺忘因子 0.15) |
| 模仿樣本降權 | ×0.196 | 權重 0.2 時的類中心位移約為滿權重的 0.196 倍 |
準確率採內部驗證口徑(14/15,93.3%)。README 早期版本曾記錄 15/15,差異來自樣本切分方式——對外一律採較保守的數字。
這五條是分析了 13 件現有貓叫識別方案後歸納出的共同弱點,也是本方案逐條設計的依據。
必須聯網普遍依賴伺服器端/雲端訓練/遠端比對。→ 本方案的整條流程全部在移動終端本地執行,音訊與特徵均不離開裝置。
依賴預訓練深度模型模型出廠即凍結,且判定不可解釋。→ 類中心由個體樣本集直接建立,不依賴任何預訓練模型。
無拒判機制遇到未覆蓋的陌生叫聲仍強行歸類,甚至給高置信度。→ 雙門檻區分「認得/拿不準/不認識」三種狀態。
不適應嗓音漂移寵物成長、患病、發情導致嗓音改變後識別率下降而無從察覺。→ 遺忘因子 0.15 的指數滑動平均自動跟隨,並以 z 值監測漂移。
小樣本類中心不穩3~5 個樣本建立的類中心易被離群樣本帶偏。→ 抗離群類內半徑 + 學習率 max(0.15, 1/(n+2)) 的兩段式設計。
技術決策、養貓觀察、錄音技巧——每一篇都有出處,沒有玄學。
這是本機互動示範。預載留言為示範內容,並非經驗證的客戶評價;你的留言不會公開或同步。
先登入再留言,這樣別人知道是誰在說話。
每一次記錄,都讓你多留下一點和牠相處的回憶。 Android 版已開放下載;iOS 版開發中,完成後會在本頁與會員通知公布。